这篇怎么读:每一节的开头都有一句「这一节要拿到的东西」,你可以据此决定要不要细读。每节里都配了一对折叠块——提示先给方向(不剧透),解答才给答案。卡住就看提示,实在不行再看解答。
| 题号 | 1477. 找两个和为目标值且不重叠的子数组 | 难度 | Medium |
| 标签 | Array · Hash Table · Binary Search · Dynamic Programming · Sliding Window | 语言 | C++(clang / libc++) |
| 我的提交 | Accepted · 16 ms · 95.7 MB · 61/61 用例 | 来源 | 力扣原题(2026-09-17 每日一题) |
今天这篇讲的是 1477. 找两个和为目标值且不重叠的子数组(Medium)。它看着像滑动窗口题,但第一次提交前把我绊住的,恰恰不是滑动窗口——而是一个关于「状态里该装什么」的问题。下面按我的实际推演顺序写。
零、先把题目摊开(复述)
这一节要拿到的东西:把题面翻译成自己的话,并且圈出那三句会决定代码长什么样的规则。
题面是:给你一个整数数组 arr 和一个整数 target,找两个互不重叠的子数组,让它们的和都等于 target,返回这两个子数组长度和的最小值;找不到就返回 -1。
里面有三句话直接决定代码长什么样,我先把它们钉死:
- 「子数组」是连续的——所以可以用区间
[l, r]表示一段,这决定了后面全是区间运算。 - 「互不重叠」指两个区间的下标集合没有交集。首尾相接是合法的:
[0,1]和[2,3]不算重叠。这一条是本题最大的坑,也是最大的福利——它让「切一刀」的玩法成立。 - 「长度和最小」说明不是随便找一对,而是要在所有合法方案里比较总长度。这意味着我们最终要做的是「取最小值」,而不是「计数」。
约束方面只记两条:n ≤ 10⁵,以及 arr[i] 全为正数(1 ≤ arr[i] ≤ 1000)。前者说明 O(n²) 会超时,后者是后面所有 O(n) 玩法的地基——没有「全为正」,这题会变成另一道题。
提示题面里哪个数字最容易看漏? · 1 条 · 约 30 秒 · 先自己想
看 arr[i] 的范围:下限是 1,不是 0、更不是负数。正数意味着「区间越长,和越大」——这是一条单调性,而单调性正是能把 O(n²) 压到 O(n) 的前提。
顺带留意官方最后一个示例 arr = [3,1,1,1,5,1,2,1], target = 3:答案是 3,用的是 arr[0] 与 arr[5..6]。它专门用来演示「首尾相接合法、但共用格子非法」。
一、建模:把它画出来
这一节要拿到的东西:一张能让你「看见」题目的图,以及一句话说清「我在挑什么」。
把数组画成一排格子,每一段就是几个连续的格子。于是题目变成:在格子排队上挑两组不相交的连续格子,两组各自的数字和都是 target,让两组格子总数的和最小。
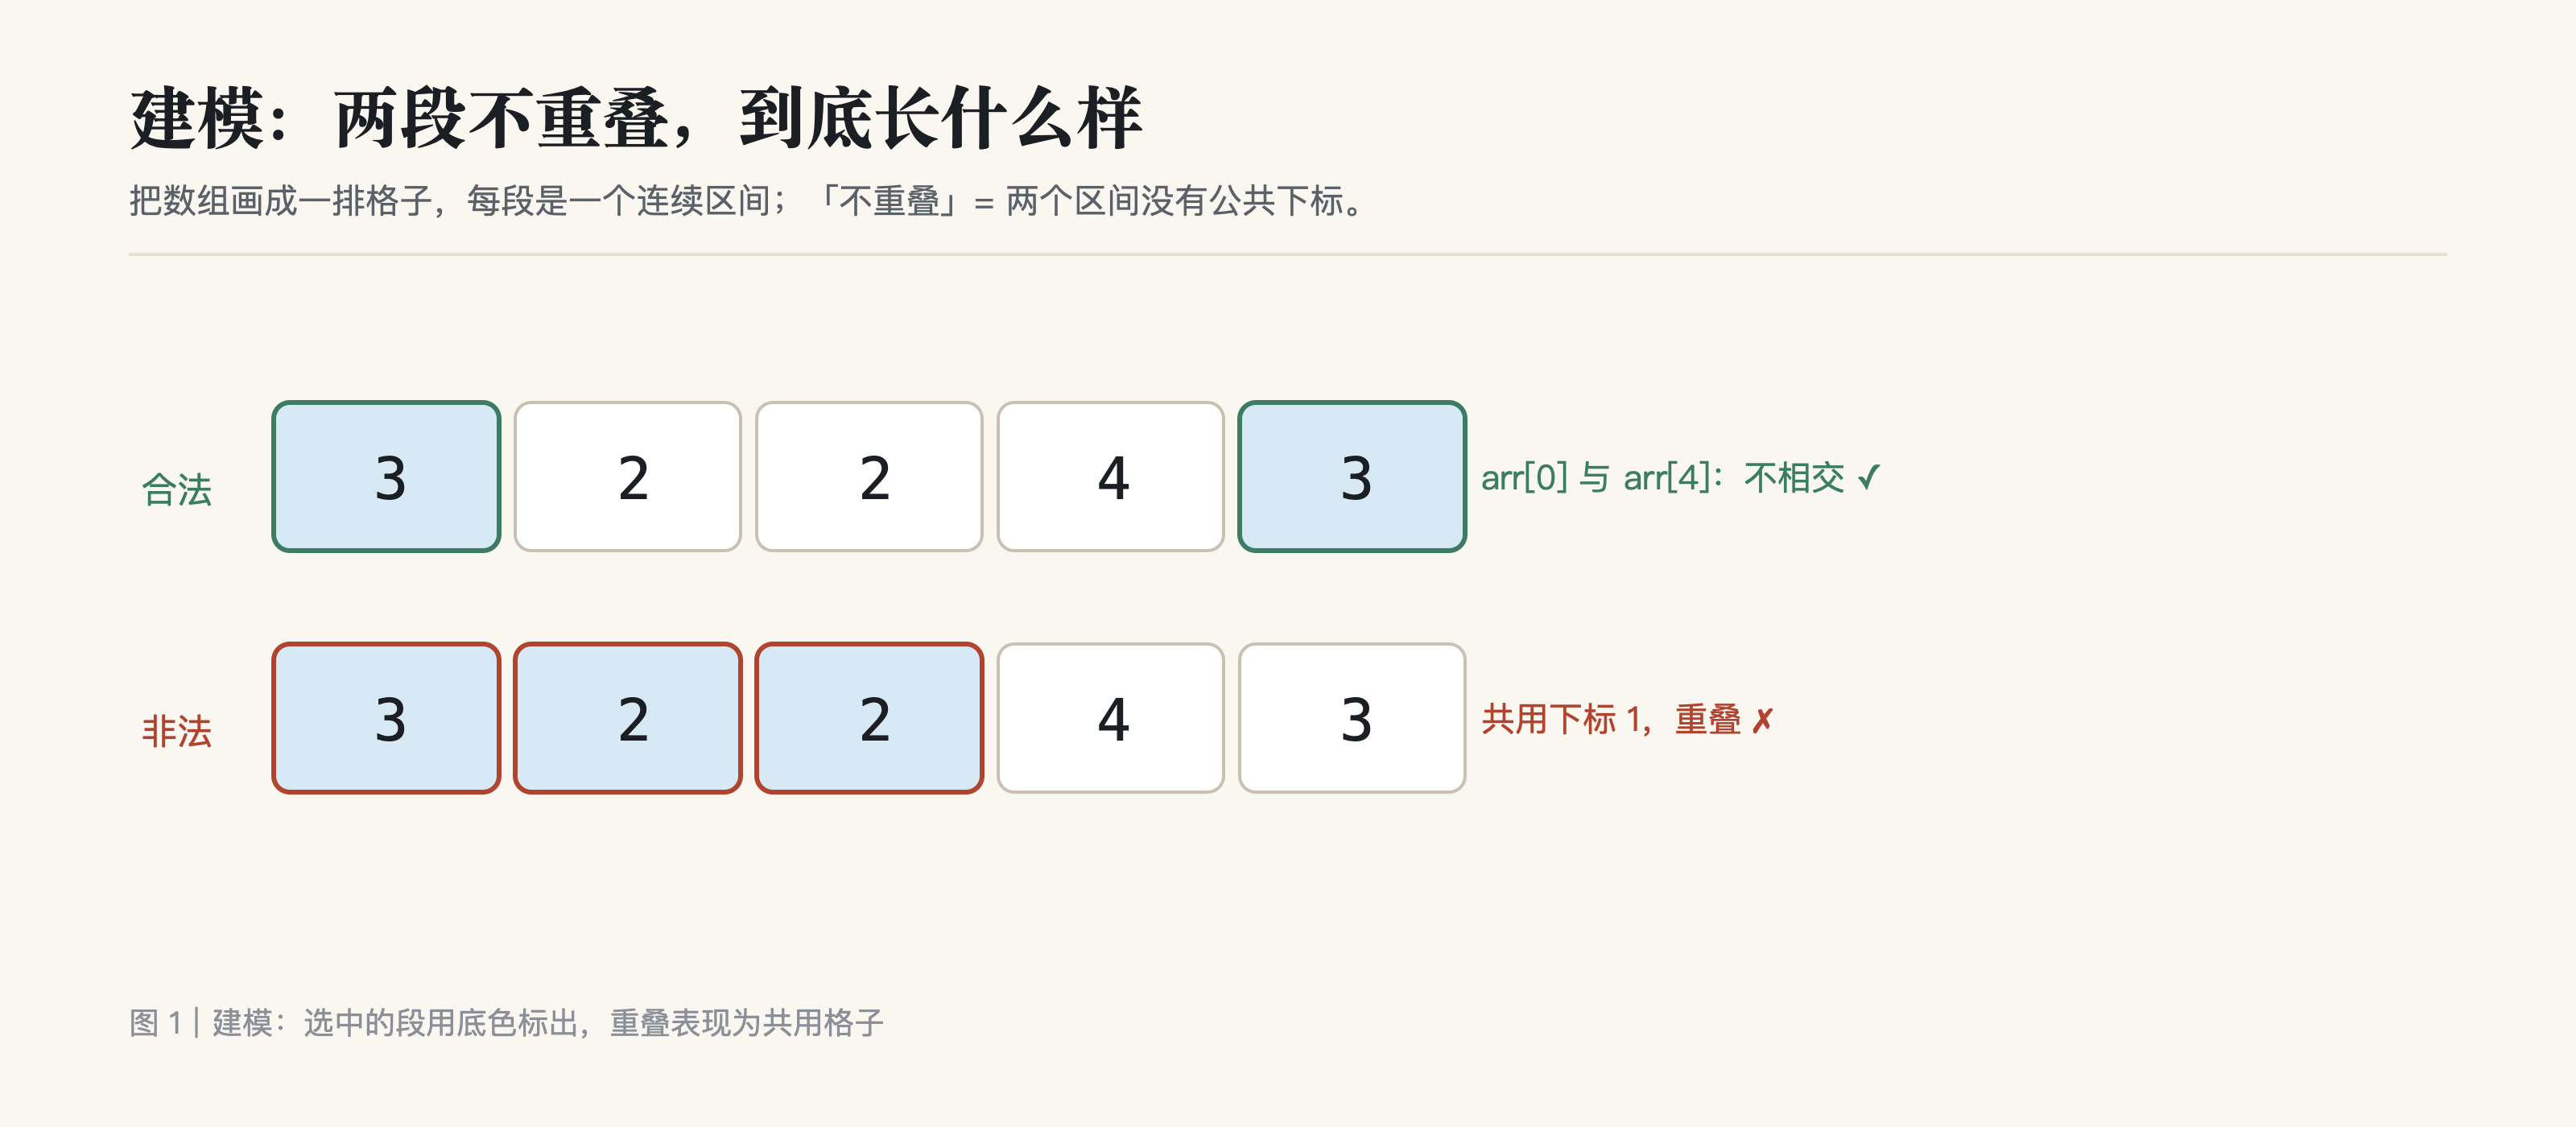
图里下面那行是关键的对照:arr[0..1] 与 arr[1..2] 都合法地为和为 target 的段,但它们共用了下标 1,因此不能同时选。这个「不能同时选」就是本题的全部难点。
提示建模该往哪个方向想? · 3 条 · 约 1 分钟 · 卡住再看
- 先把「找段」和「选一对段」拆成两件事——它们的难度完全不同,混在一起想会卡死。
- 「找段」在正数条件下有单调性可用(右端右移和必增),想想双指针。
- 「选一对」的核心矛盾是「不重叠」这个约束;试着找一个能把约束变成结构的视角,而不是写 if 去判断它。
二、手数最小规模:这是整道题的地基
这一节要拿到的东西:一组能手工验证的答案,它是你以后验任何代码的标尺。
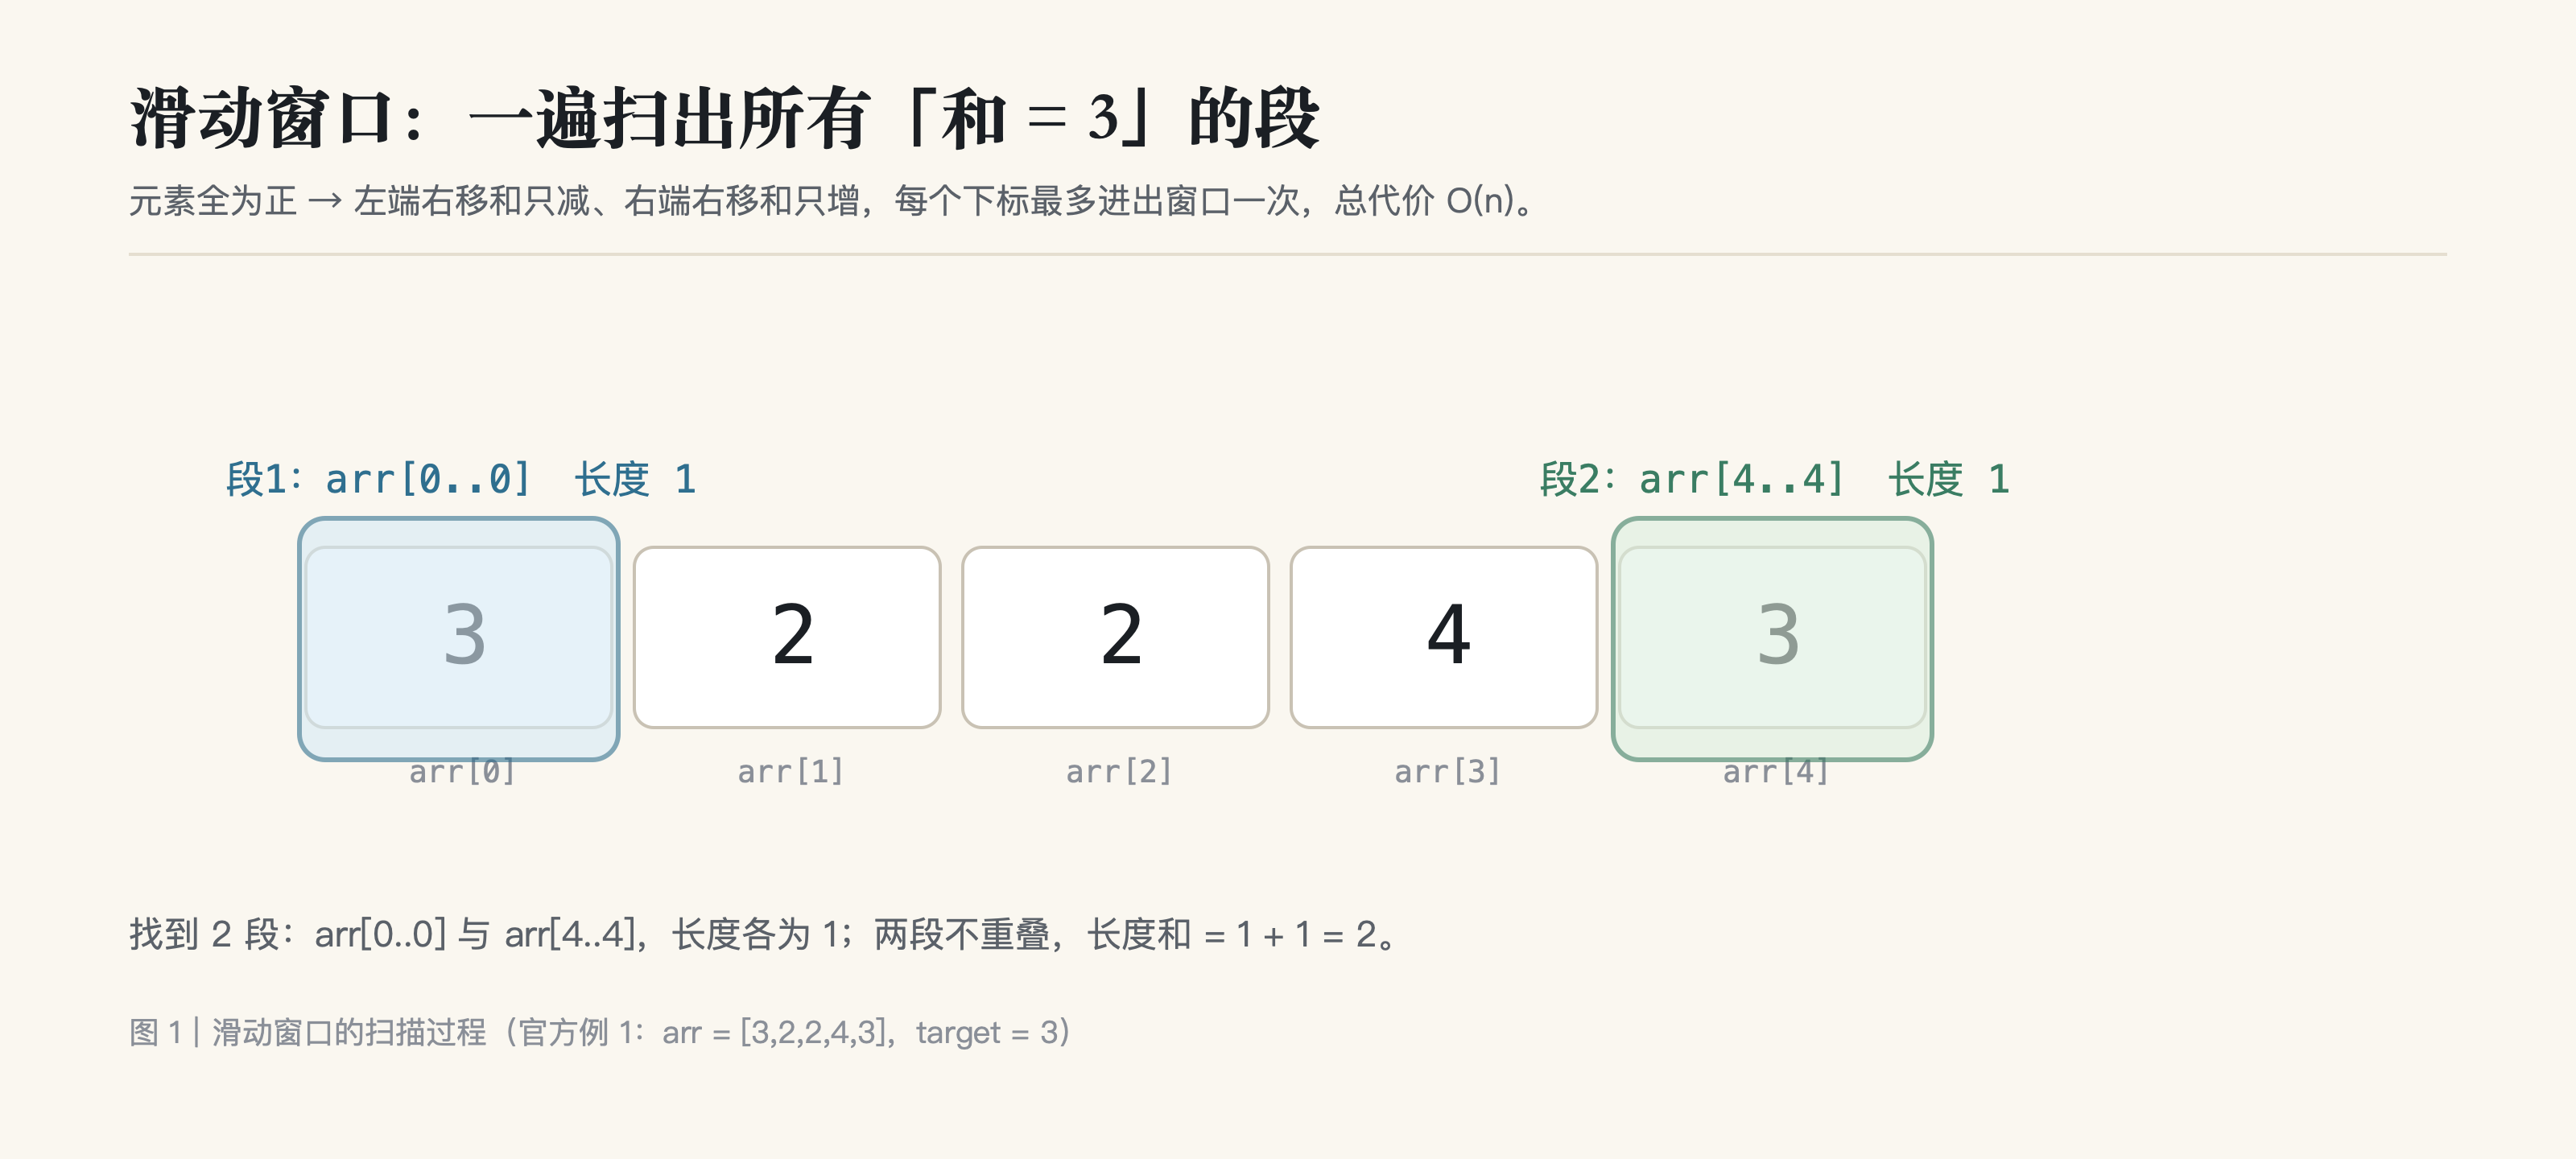
拿官方第一组示例 arr = [3,2,2,4,3]、target = 3 手工数:和为 3 的连续段有两处——arr[0](值 3)与 arr[4](值 3)。它们不相交,长度和 1 + 1 = 2。这个好数。
换官方第三组 arr = [4,3,2,6,2,3,4]、target = 6,我第一遍就数错了——我以为有两段,其实只有一段。为了不再靠感觉,我写了个四行的枚举程序把五组示例全部跑出来,实测结果如下:
arr=[3,2,2,4,3]        target=3  合格段: [0..0][4..4]                    答案 = 2
arr=[7,3,4,7]          target=7  合格段: [0..0][1..2][3..3]              答案 = 2
arr=[4,3,2,6,2,3,4]    target=6  合格段: [3..3]                          答案 = -1
arr=[5,5,4,4,5]        target=3  合格段: (无)                             答案 = -1
arr=[3,1,1,1,5,1,2,1] target=3 合格段: [0..0][1..3][5..6][6..7] 答案 = 3两组数字值得停下来看:例 2 有三段合格段([0..0]、[1..2]、[3..3]),最优选法是取两头各长 1 的,答案是 2;例 5 有四段,其中 [5..6] 与 [6..7] 共用下标 6,不能同时选,最优是 [0..0] + [5..6] = 1 + 2 = 3。
| 示例 | arr / target | 合格段(实测) | 答案 | 我的解读 |
|---|---|---|---|---|
| 例 1 | [3,2,2,4,3] / 3 | [0..0] [4..4] | 2 | 两头各一段,不相交 |
| 例 2 | [7,3,4,7] / 7 | [0..0] [1..2] [3..3] | 2 | 三段里挑两头,中段被排除 |
| 例 3 | [4,3,2,6,2,3,4] / 6 | [3..3] | −1 | 只有一段,凑不出两个(我第一遍数错了) |
| 例 4 | [5,5,4,4,5] / 3 | (无) | −1 | 元素最小是 4 |
| 例 5 | [3,1,1,1,5,1,2,1] / 3 | [0..0] [1..3] [5..6] [6..7] | 3 | [5..6] 与 [6..7] 共用下标 6,只能选一个 |
这一节真正的收获不是那五个数字,而是方法:这道题的「合格段」肉眼很难数准(我第一遍就错了),所以从下一节开始,理解与验证都交给程序;手算只用来判断量级和建立直觉。
提示手数时最容易犯的两个错 · 2 条 · 约 40 秒 · 先自己数完再看
- 把「和恰好等于 target」与「和小于 target」搞混——比如例 3 里
[1..2] = [3,...]吗?实际arr[1..2] = [3,2]和是 5,不是 6。 - 忘了「重叠不能同时选」——例 5 有四段,但不是任意两段都能配对,
[5..6]与[6..7]就冲突。
三、第一条路:暴力怎么做到不重不漏
这一节要拿到的东西:一条能写出来的完整解法(虽然会超时),以及它为什么不够快。
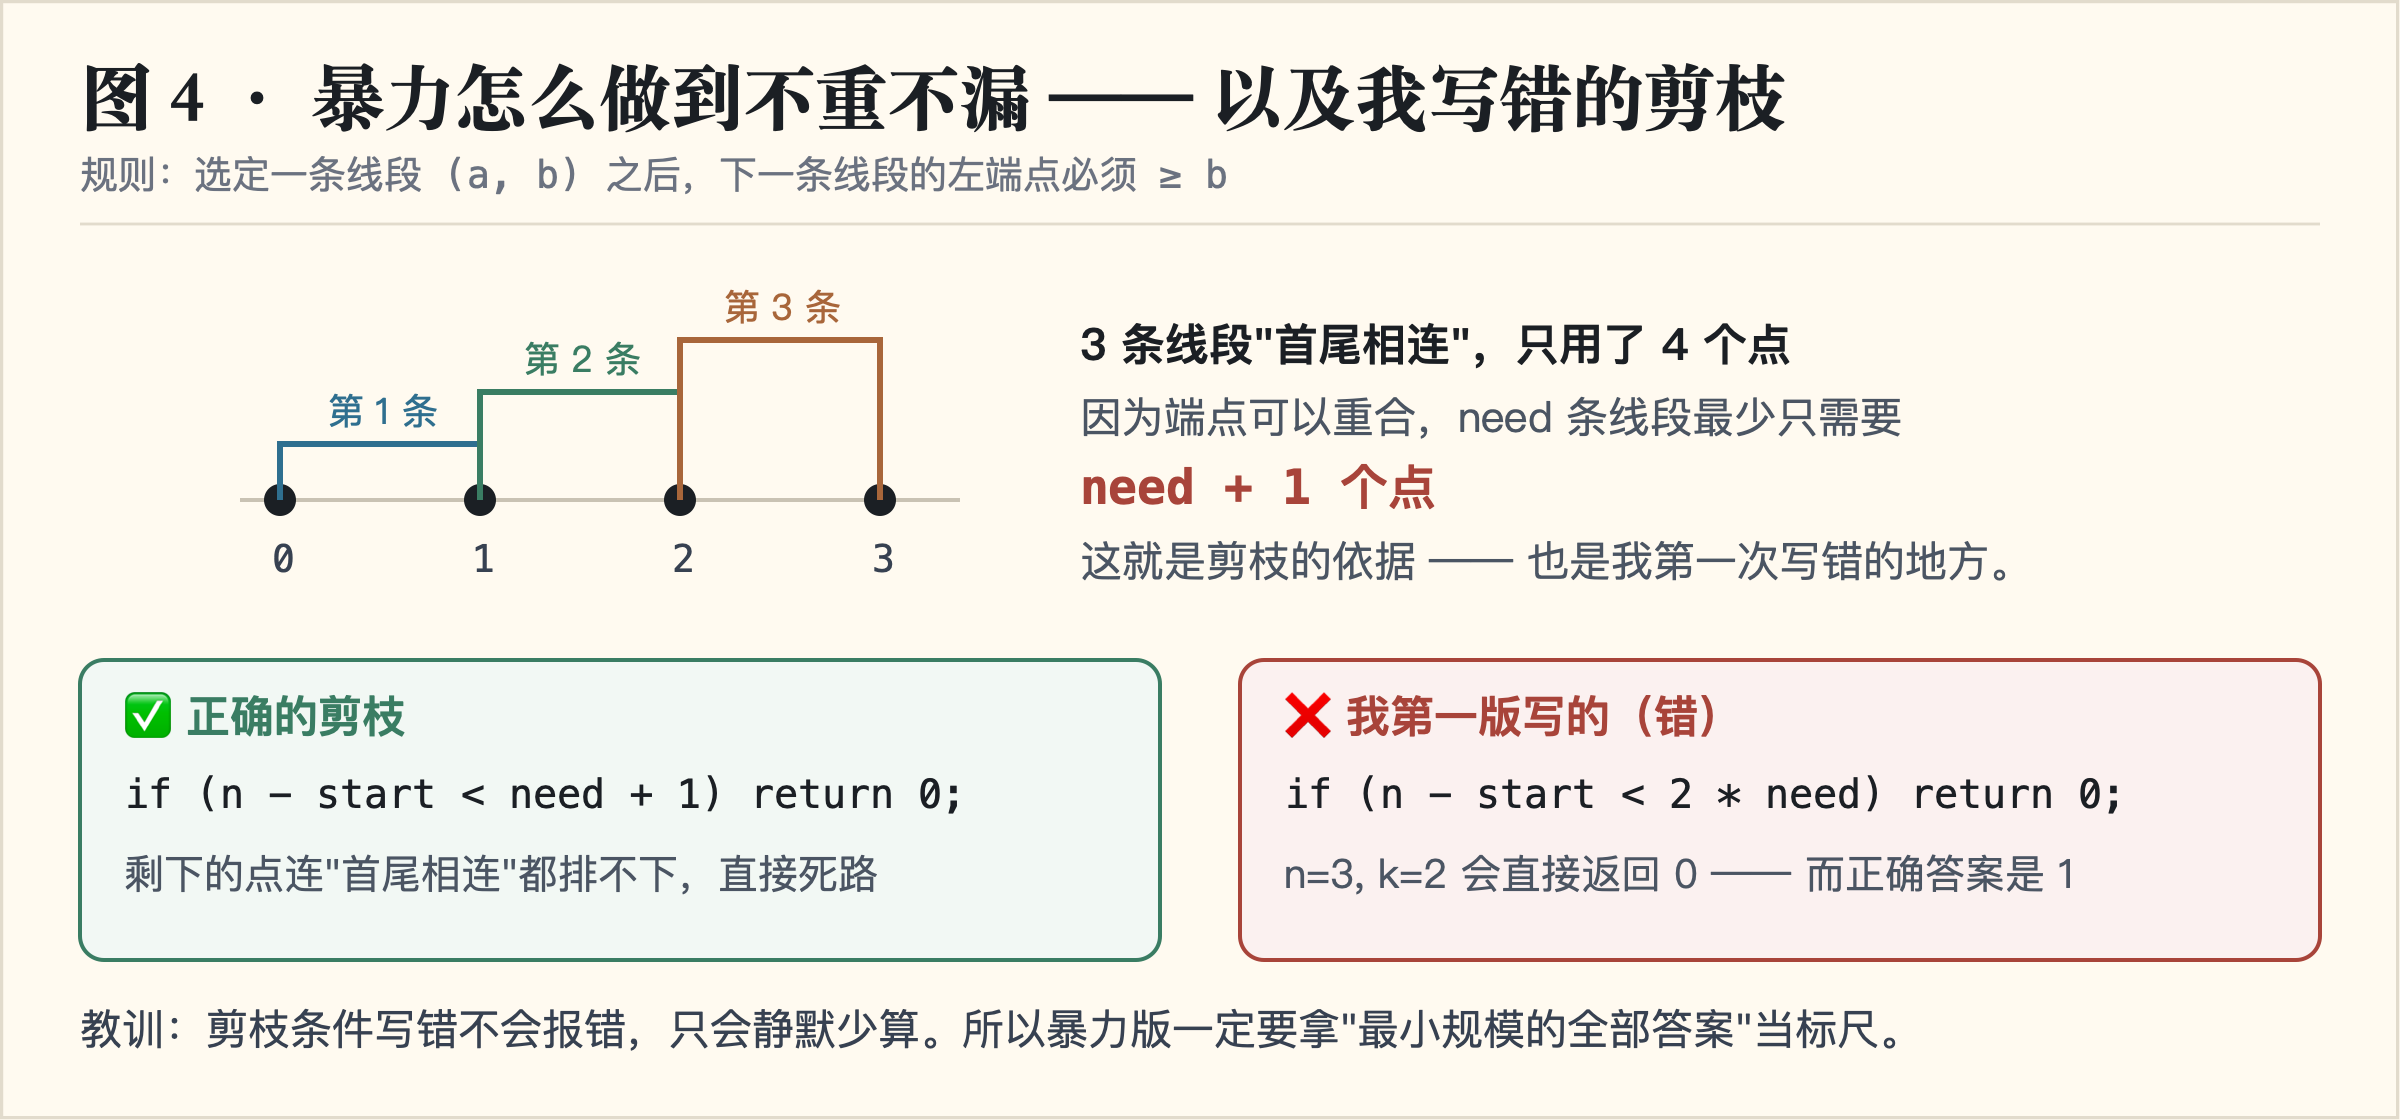
暴力路的思路最直白,分两步:先枚举出所有和为 target 的段,再在段表里两两挑一对不相交的,取长度和最小。
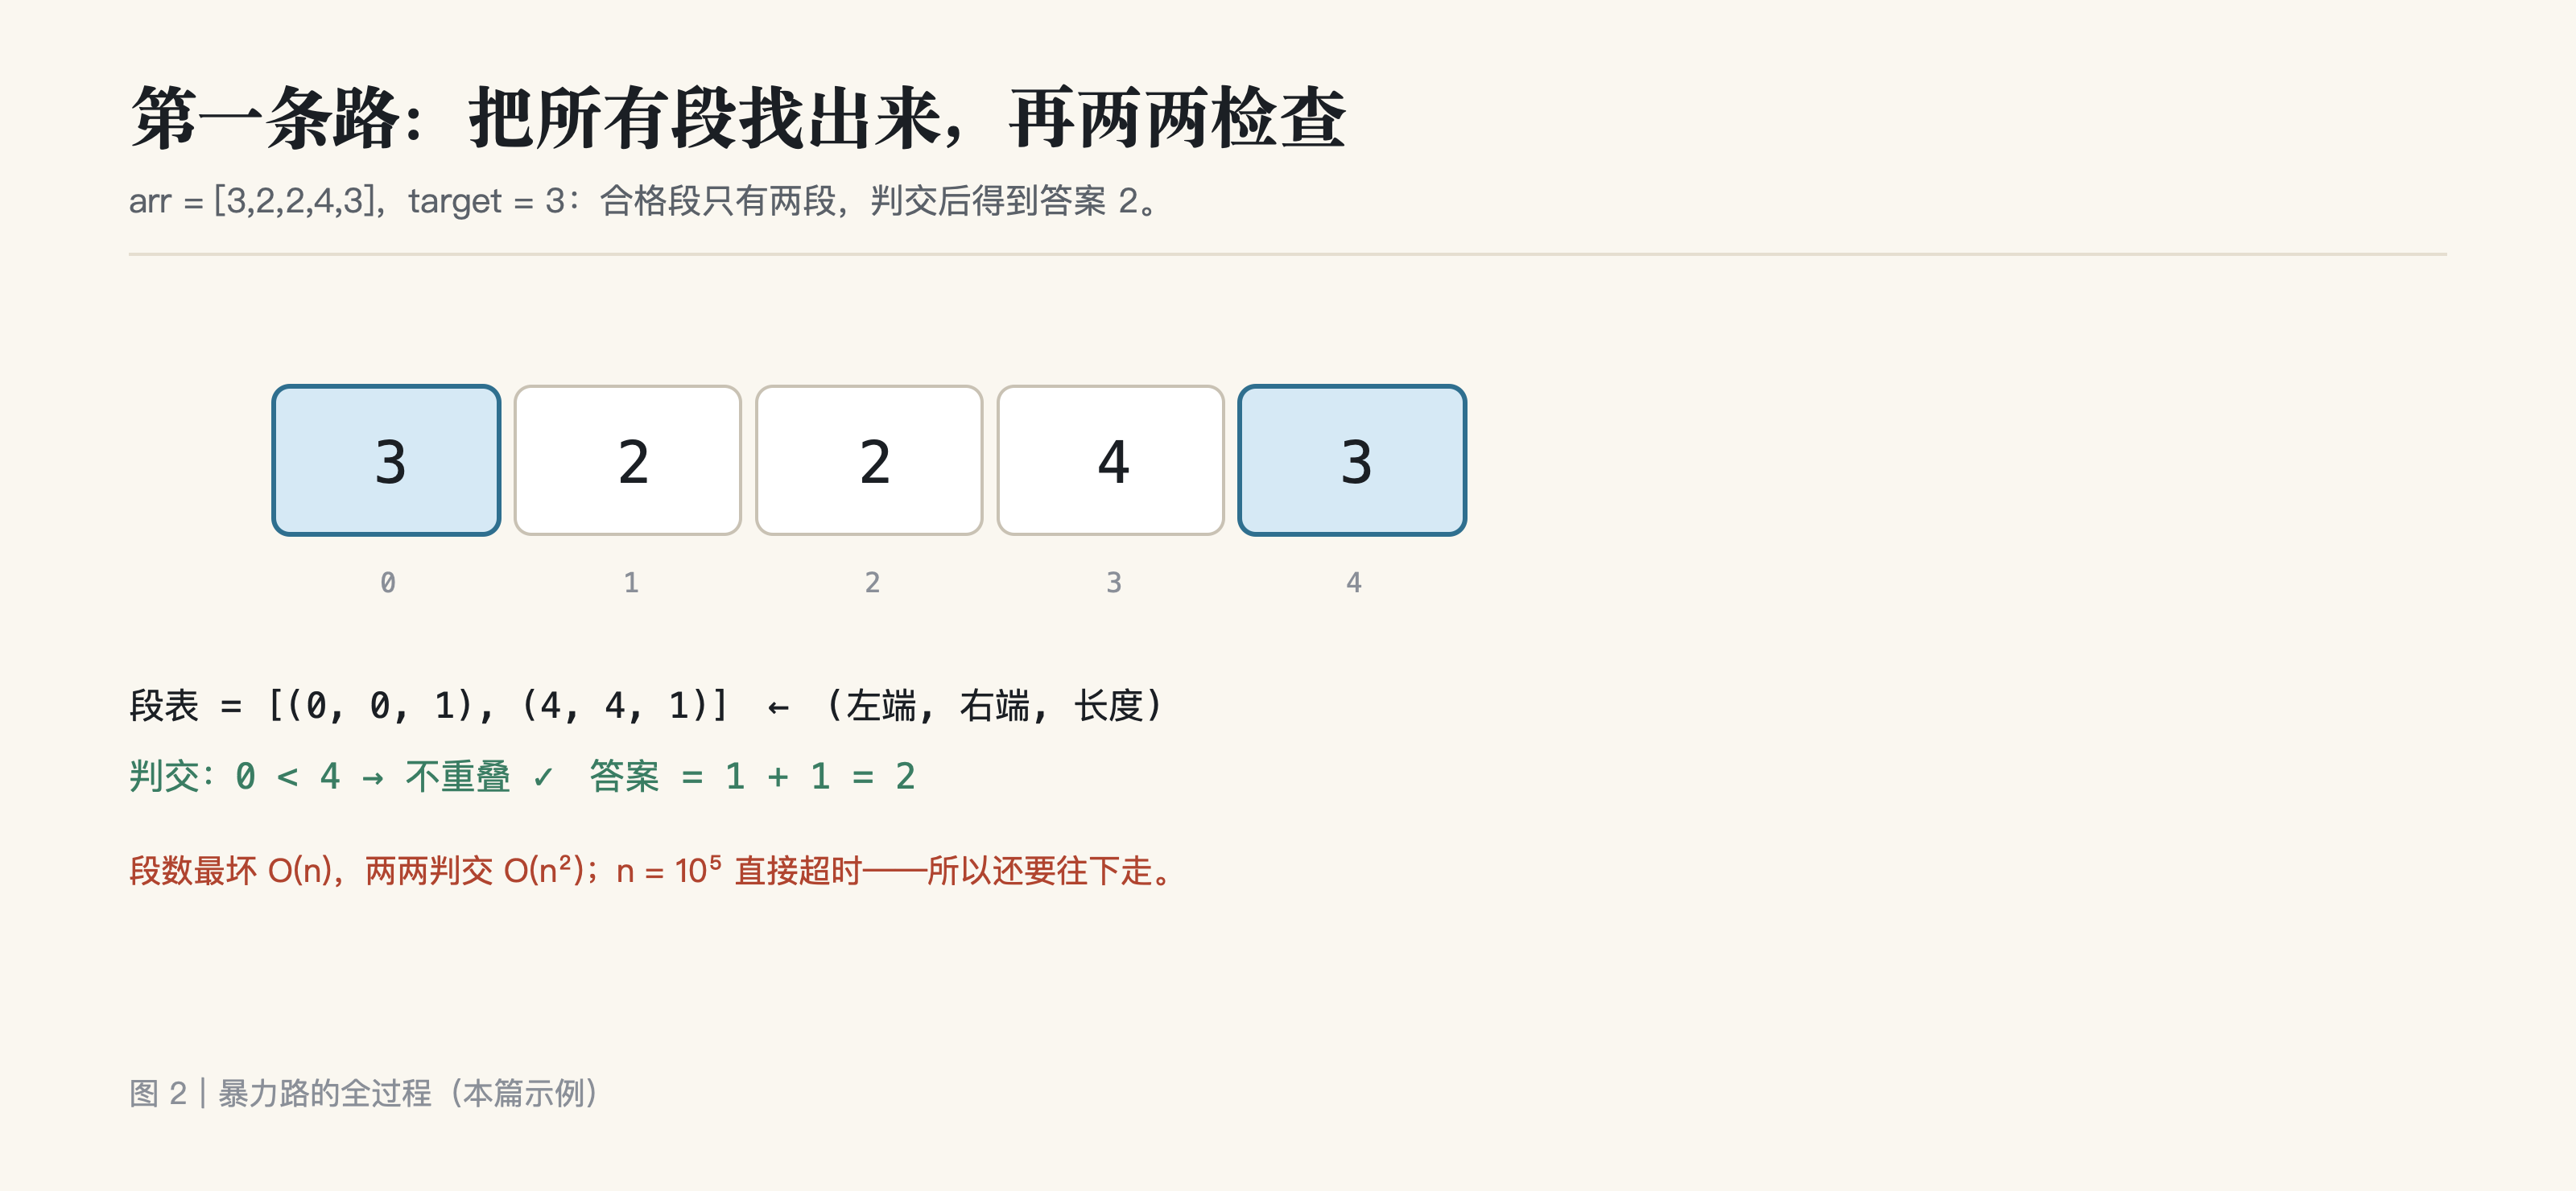
判交的条件值得写清楚,因为它是后面所有优化的基础:两段 [a,b] 与 [c,d](假设 a ≤ c)不重叠 ⇔ b < c。注意是 < 而不是 ≤——首尾相接(b = c−1)是合法的。
提示剪枝条件该怎么写? · 3 条 · 约 1 分钟 · 卡住再看
- 枚举段时,如果当前和已经超过
target,可以立刻停——因为后面只会更大(正数)。注意是「超过」而不是「达到」。 - 判交可以只看一个方向:固定左边的段,右边段的左端必须严格大于左边段的右端。
- 想想最坏情况:如果数组里到处都是合格段(比如全 1、
target = 2),段表会有多大?这决定了复杂度。
解答暴力版代码 + 它的复杂度(含一个我写错过的版本) · 约 2 分钟
vector<pair<int,int>> seg;                 // 先枚举所有合格段
for (int i = 0; i < n; ++i) {
    long long sum = 0;
    for (int j = i; j < n; ++j) {
        sum += arr[j];
        if (sum == target) seg.push_back({i, j});
        if (sum > target) break;             // 是 > 不是 >=
    }
}
int best = -1;                            // 再两两判交
for (size_t a = 0; a < seg.size(); ++a)
    for (size_t b = a + 1; b < seg.size(); ++b) {
        if (!(seg[a].second < seg[b].first || seg[b].second < seg[a].first)) continue;
        int len = (seg[a].second - seg[a].first + 1) + (seg[b].second - seg[b].first + 1);
        if (best == -1 || len < best) best = len;
    }
复杂度:枚举段 O(n²),两两判交 O(段数²) = O(n²),总计 O(n²)——n = 10⁵ 时是 10¹⁰ 量级,必然超时。但它是对的,所以它能当作对数器(见第七节)。
我写错过的版本:剪枝那一行我最初写的是 if (sum >= target) break;。看起来更省事,实际会漏段——当 sum 恰好等于 target 时它直接跳出,把刚记下的那一段之后的可能全砍了;某些用例上它会少找段,从而给出偏大的答案。这个 bug 让我在对拍时一度以为是主解错了。
四、第二条路:设计状态,把「选」变成「递推」
这一节要拿到的东西:一个能一趟扫完的状态定义,以及它第一次写错的原因(这一段是本篇最值钱的部分)。
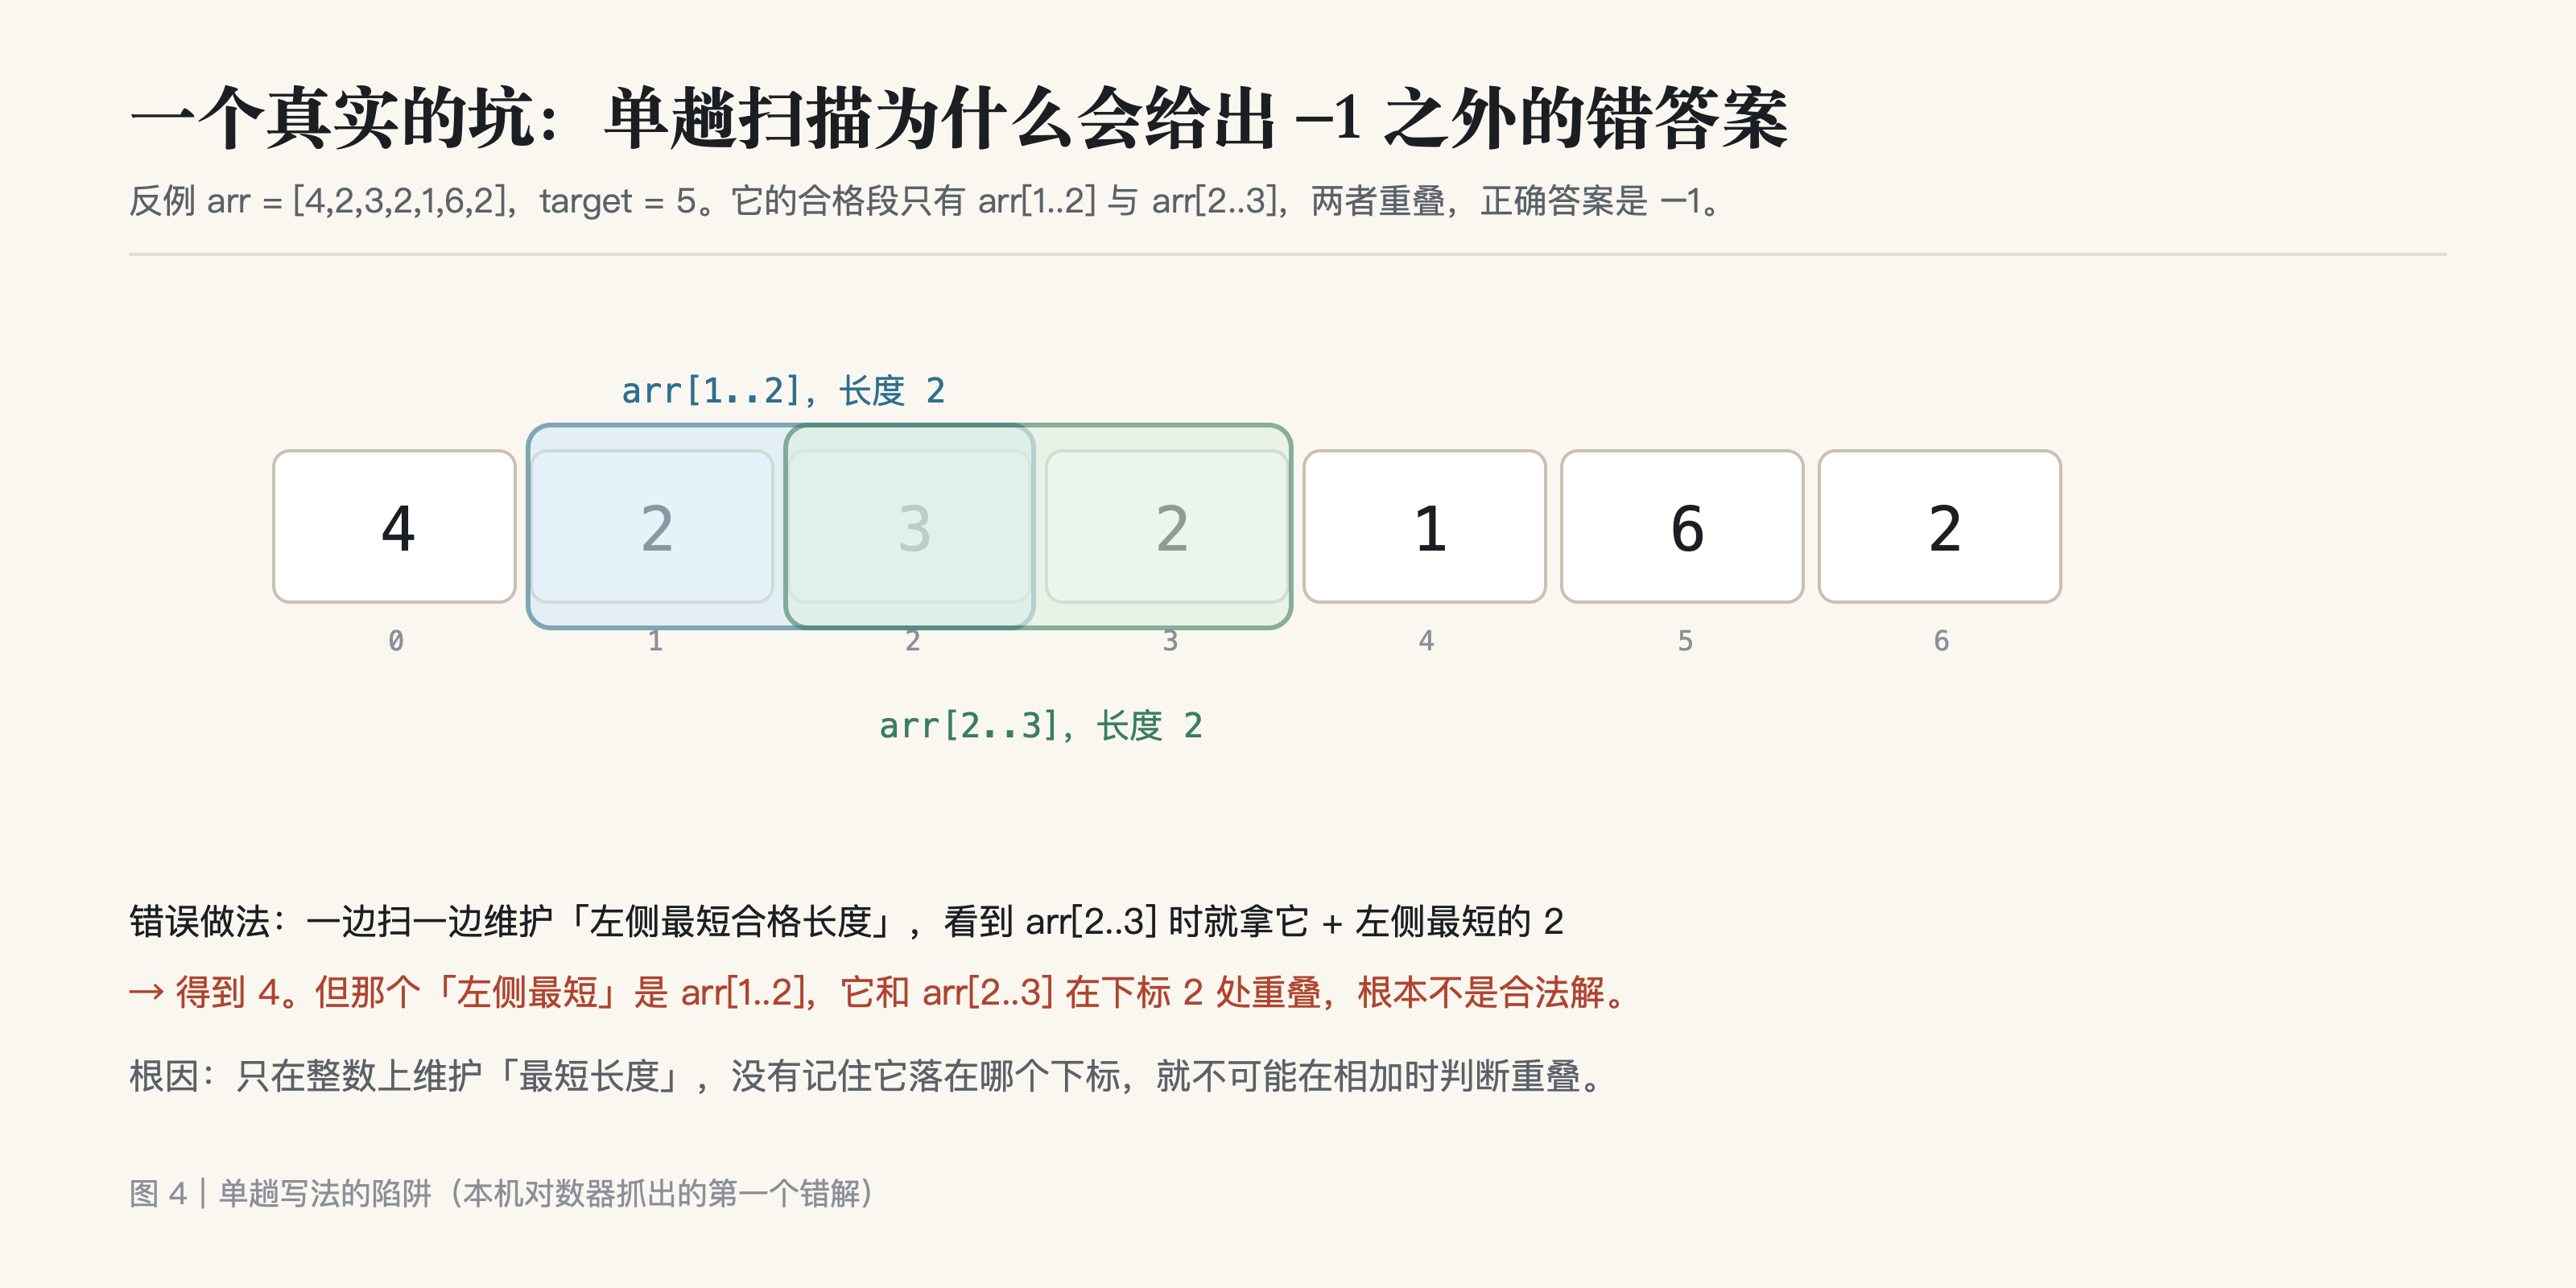
暴力慢在「两两判交」。想一趟扫完,直觉是:边扫边记住「左边出现过的最短段长」,遇到新段就拼接。
我第一版就是这么写的,而且官方给的五组示例全过。但它有个致命缺陷:我只记住了「最短段有多长」,没记住「那段落在哪里」。当新段与那个「最短段」共用了格子时,代码照样把它们相加——于是给出一个比正确答案更小的数。
提示状态该怎么定义、转移从哪来 · 3 条 · 约 1 分钟 · 卡住再看
- 问自己:要判断两段不重叠,状态里最少必须装什么?只装长度够不够?
- 试试把状态定义在「下标」上而不是「长度」上:例如「右端点不超过某个位置的最短段长」。
- 每加入一个新段,它能和哪些段组合?把「哪些」写成一个关于下标的条件,就能变成一次查询。
解答正确的单趟状态 + 代码(剧透) · 约 2 分钟
关键是把状态定义在位置上:维护一个数组 bestUpTo[e],表示「右端点 ≤ e 的所有合格段里最短的长度」。于是一段 arr[start..i-1] 出现时,能和它组合的左边段必须满足「右端点 ≤ start−1」,直接查 bestUpTo[start-1] 即可——位置约束变成了数组下标约束。
查找「和等于 target」的段用前缀和 + 哈希表:记 P[i] = arr[0..i-1] 之和,则段 [start, i) 的和等于 target ⇔ P[start] = P[i] − target。
const int n = (int)arr.size(), INF = 1e9;
vector<int> bestUpTo(n, INF);            // bestUpTo[e]:右端点 <= e 的最短合格段长
unordered_map<long long,int> pos; pos[0] = 0;   // P[0] = 0,下标 0
long long pre = 0; int ans = INF;
for (int i = 1; i <= n; ++i) {
    pre += arr[i-1];
    auto it = pos.find(pre - target);
    if (it != pos.end()) {
        int start = it->second;           // 段 = arr[start .. i-1]
        int len = i - start;
        if (start - 1 >= 0 && bestUpTo[start - 1] != INF)
            ans = min(ans, bestUpTo[start - 1] + len);
        bestUpTo[i - 1] = min(bestUpTo[i - 1], len);
    }
    pos[pre] = i;
}
// 把 bestUpTo 变成真正的前缀最优(从右端点小的方向传递过来)
for (int e = 1; e < n; ++e) bestUpTo[e] = min(bestUpTo[e], bestUpTo[e - 1]);
return ans >= INF ? -1 : ans;
实测:这条实现在本机与暴力对拍 20000 组随机数据完全一致(见第七节)。
五、还有第三条路:滑窗找段 + 两侧最优 + 切一刀
这一节要拿到的东西:一个把「不重叠」彻底结构化的写法——它不需要任何判交,因此也不会写错判交。
上一节的解法已经能过,但它仍然在代码里依赖「查表 + 判断」。换个视角会舒服得多:任取一对不重叠的段,按右边那段的左端点切一刀,左边段必落在刀左侧、右边段必落在刀右侧。于是我们只需要两张表:
bestEnd[r]:右端点 ≤ r 的所有合格段里最短的长度(前缀最优)。bestStart[l]:左端点 ≥ l 的所有合格段里最短的长度(后缀最优)。
然后枚举切点 k,答案就是 min(bestEnd[k-1] + bestStart[k])。两段分处切点两侧,不重叠由结构保证,代码里一个判交都不需要写。
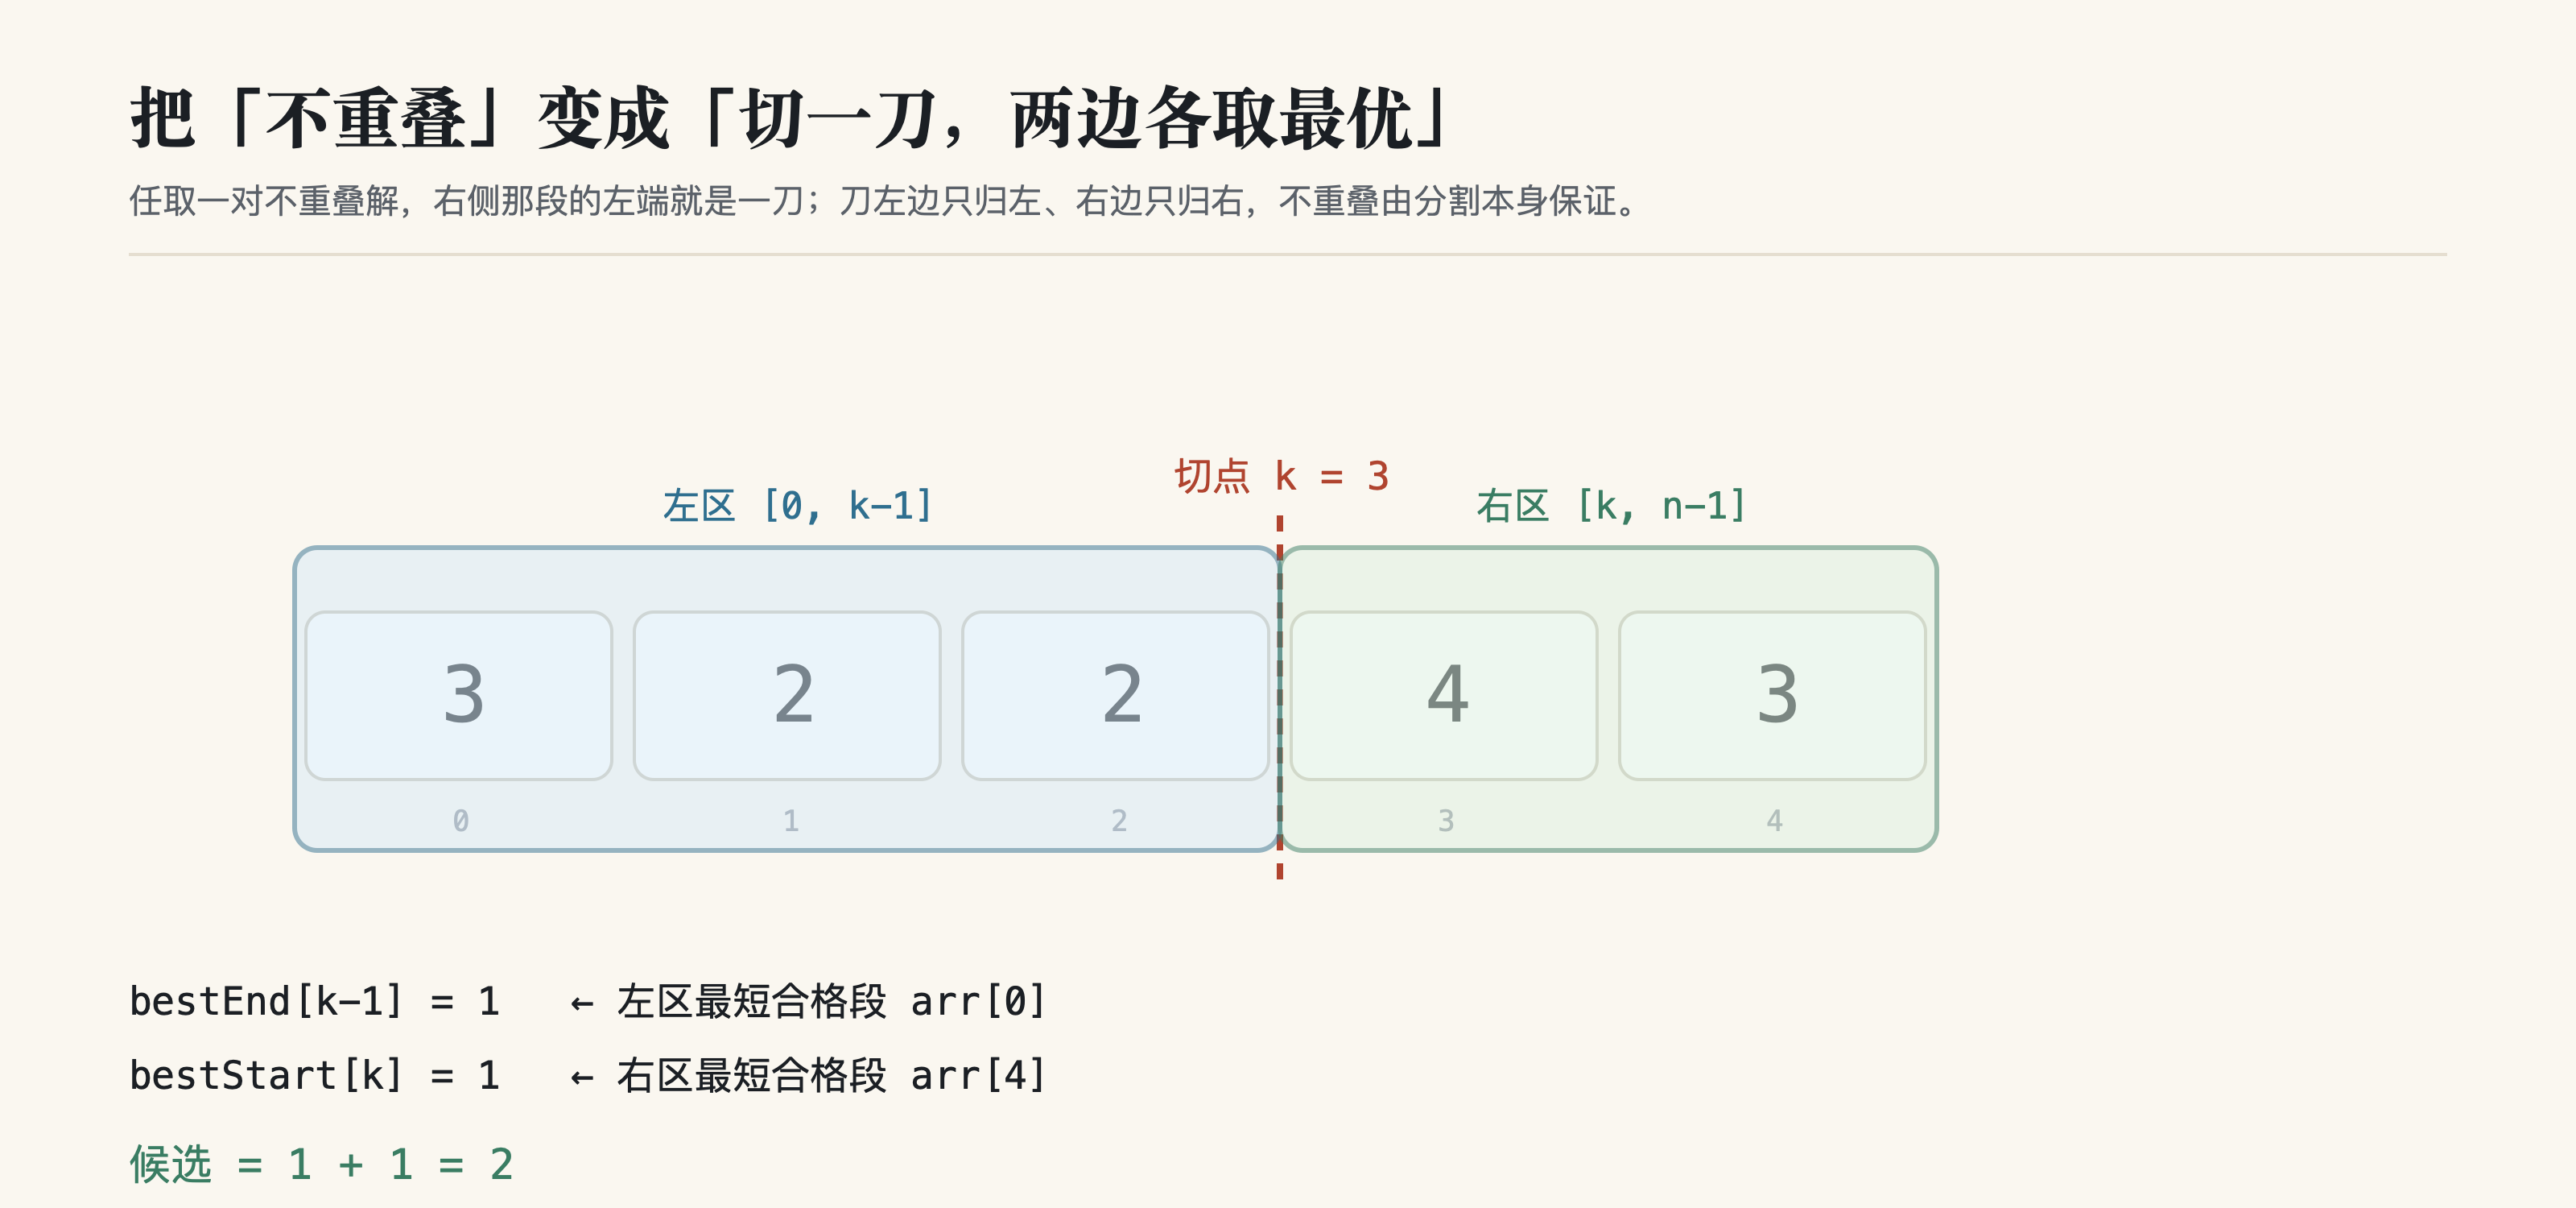
「找段」这一步用滑动窗口,正好吃到「元素全为正」这个约束:右端右移和必增、左端右移和必减,所以 lo 与 hi 都只单向前进,总代价 O(n)。
提示为什么切点枚举是完备的? · 3 条 · 约 1 分钟 · 卡住再看
- 任取一个合法方案(两段不重叠),把右边那段的左端点拿出来当切点,会发生什么?
- 反过来,固定切点取「左区最优 + 右区最优」,这两个段有可能重叠吗?为什么?
- 把「所有切点都试一遍」的代价算一下:如果两侧最优都是 O(1) 查询,总代价是多少?
解答完备性证明 + 滑动窗口代码(剧透) · 约 2 分钟
完备性(一进一出):设某一对合法解的右段为 [p, q]。取切点 k = p 时,左段整体在 [0, p-1] 内,所以 bestEnd[p-1] 取到的长度 ≤ 该左段;右段整体在 [p, n-1] 内,所以 bestStart[p] ≤ 该右段。因此切点 p 给出的候选 ≤ 这一对的总长——枚举到它就不会漏掉最优解。反过来,bestEnd[k-1] 的段右端点 ≤ k−1、bestStart[k] 的段左端点 ≥ k,两者下标集合天然不相交,所以每个候选都合法。不漏 + 不假,故完备。
// 第一步:滑动窗口找出所有合格段
vector<pair<int,int>> windows;
long long sum = 0; int lo = 0;
for (int hi = 0; hi < n; ++hi) {
    sum += arr[hi];
    while (sum > target && lo <= hi) sum -= arr[lo++];
    if (sum == target) windows.push_back({lo, hi});
}
// 第二步:两侧最优表
vector<int> bestEnd(n, INF), bestStart(n, INF);
for (auto& w : windows) {
    int len = w.second - w.first + 1;
    bestEnd[w.second]  = min(bestEnd[w.second], len);
    bestStart[w.first] = min(bestStart[w.first], len);
}
for (int r = 1; r < n; ++r)      bestEnd[r]   = min(bestEnd[r], bestEnd[r - 1]);
for (int l = n - 2; l >= 0; --l) bestStart[l] = min(bestStart[l], bestStart[l + 1]);
六、落地:我的提交代码
下面就是实际提交并通过的那一份(Accepted · 16 ms · 95.7 MB · 61/61),没有为了文章改过一行。
class Solution {
public:
    int minSumOfLengths(vector<int>& arr, int target) {
        const int n = (int)arr.size();
        const int INF = 1e9;

        // 第一步:滑动窗口找出所有和为 target 的段
        vector<pair<int, int>> windows;
        long long sum = 0;
        int lo = 0;
        for (int hi = 0; hi < n; ++hi) {
            sum += arr[hi];
            while (sum > target && lo <= hi) sum -= arr[lo++];
            if (sum == target) windows.push_back({lo, hi});
        }

        // 第二步:两侧最优表
        vector<int> bestEnd(n, INF), bestStart(n, INF);
        for (auto& w : windows) {
            int len = w.second - w.first + 1;
            bestEnd[w.second]  = min(bestEnd[w.second], len);
            bestStart[w.first] = min(bestStart[w.first], len);
        }
        for (int r = 1; r < n; ++r)      bestEnd[r] = min(bestEnd[r], bestEnd[r - 1]);
        for (int l = n - 2; l >= 0; --l) bestStart[l] = min(bestStart[l], bestStart[l + 1]);

        // 第三步:枚举切点
        int answer = INF;
        for (int k = 1; k < n; ++k) {
            if (bestEnd[k - 1] == INF || bestStart[k] == INF) continue;
            answer = min(answer, bestEnd[k - 1] + bestStart[k]);
        }
        return answer >= INF ? -1 : answer;
    }
};复杂度:滑动窗口 O(n)(每个下标进出各一次),填两张表各 O(n),枚举切点 O(n),空间 O(n)。整体 O(n) 时间 / O(n) 空间。
三种边界死法(你可能会写错的地方) · 约 1 分钟
n == 1:枚举切点的循环一次都不执行,直接返回 −1——但如果你把切点循环写成k ≤ n,会越界。- 没有合格段:两张表全是 INF,相加会溢出吗?答案是不会(1e9 + 1e9 仍在 int 内),但更稳的写法是先判断
== INF再相加,我采用后者。 - 恰好两段且首尾相接:这是合法解,切点落在两段之间时两侧都有值,必须能被枚举到——检查你的切点循环是从
k = 1开始且到n-1结束。
七、验证:我为什么敢说它是对的
这一节要拿到的东西:一个叫对数器的小习惯——它比任何题解都值钱。
流程是三道关,一道都不能省:
- 第一关 · 官方示例:五组示例全过。但这一关几乎不能说明问题——本篇第一版错解就是五组全过的。
- 第二关 · 对数器:写一个「显然正确但很慢」的暴力实现,与正式解在20000 组随机小数据上逐一对比。这一关抓出了第一版的 1164 处不一致。
- 第三关 · 消毒器:用
-fsanitize=address,undefined编译再跑一遍,确认没有越界与未定义行为。
对数器:三句话说完 · 约 40 秒
① 写一份慢但直白的实现(比如枚举 + 两两判交);② 用固定种子生成上千组小规模随机数据;③ 两边同时跑,任何一组结果不同就停下来看最小反例。
它之所以强,是因为它不依赖你「想得到边界」——随机组合会替你撞出那些你想不到的用例。
本篇三关的实测数据(含一个反直觉的发现) · 约 1 分钟
- 第一版错解:官方 5 例全过;对拍 20000 组 → 1164 组不一致;最小反例
arr = [4,2,3,2,1,6,2], target = 5(正确答案 −1,错解给 4)。 - 改用「两侧最优 + 切点枚举」后:对拍 20000 组全部一致,消毒器无告警。
- 反直觉的发现:对拍第一次报错时,我先怀疑的是主解,结果手工核了最小反例,发现主解没错,是我的暴力实现写错了(
>=写成了提前跳出,恰好漏掉「和恰好等于 target」那一步)。对数器本身也会错——所以它也必须被怀疑。
八、复盘:今天能带走的东西
这一节要拿到的东西:一条可迁移的招式,和一条关于「写作纪律」的教训。
迁移卡(剥掉故事壳):凡是「在序列上挑若干个互不相交的区间,使某个可加指标最优」的题,都可以先试着把「不相交」翻译成「按切点分左右」——然后用前缀最优 + 后缀最优把「两侧各取最优」压成 O(1) 查询,最后枚举切点拼答案。这套骨架的关键收益是:约束被结构吃掉了,而不是被 if 判断掉,因而没有判断写错的空间。
不能直接迁移的部分也要说清楚:本題「枚举所有合格段」这一步依赖元素全为正(滑窗的单调性)。换成正负混合,或者要求恰好 k 段(k > 2),枚举那一步必须换手段;但「切点 + 两侧最优」这一半依然成立。
| 路径 | 核心动作 | 复杂度 | 是否要写判交 |
|---|---|---|---|
| 一 · 暴力 | 枚举全部段,两两判交取最小 | O(n²) | 要(b < c) |
| 二 · 单趟状态 | 前缀和哈希找段,用 bestUpTo[start−1] 组合 | O(n) | 要(转成下标查询) |
| 三 · 切一刀 | 滑窗找段 + 两侧最优表 + 枚举切点 | O(n) | 不要(结构保证) |
另一条教训是关于写作本身的。本文的第二节我用手算给出了第三组示例的段,而且是错的——我在正文里连续算错两次,最后才意识到该用脚本枚举。这暴露了一个纪律问题:文章里出现的每一个数字都必须是程序输出,不能是手算;手算只能用来做「量级判断」和「理解过程」,一旦要写进文章,就必须有可复现的取值来源。这篇重写时我已经把该节改为如实记录这次纠错,并把所有数字换成实测输出。
自查:六道自测题(能顺口答出 ③④⑤ 就算过了) · 约 2 分钟 · 值得认真做一遍
- 本题的「不重叠」到底指什么?
[0,1]与[2,3]合法吗? - 为什么「元素全为正」是滑窗能用的前提?如果允许负数,哪一步会失效?
- 「只维护最短长度、不维护位置」为什么会出错?给出一个反例。
- 为什么切点枚举是完备的?请分别说明「不漏」与「不假」。
bestEnd与bestStart各自是怎么递推的?为什么一个正向、一个反向?- 对数器为什么比官方示例更能发现问题?它本身可能错在哪里?
附录 · C++ 小抄(小白版,逐条讲透)
上面那些折叠块是「卡住了才点」;这一节反过来——它不剧透任何东西,所以不折叠。每一条都按同一个套路讲:它是什么 → 为什么有用 → 一段能跑的代码 → 这道题里我用在哪。
1. vector<int> 与下标访问:本题的两种「容器」
它是什么:vector 是长度可变的数组;本题里我用了两种用法——vector<int> 装「每个位置的最优长度」,vector<pair<int,int>> 装「段的左右端点」。
为什么有用:前缀最优表需要按下标随机读写(bestEnd[r]),段的列表只需要顺序遍历。两种需求对应两种容器。
vector<int> bestEnd(n, INF);              // n 个元素,全部初始化为 INF
vector<pair<int,int>> windows;           // 空的,用 push_back 追加
windows.push_back({lo, hi});              // 追加一段
int len = w.second - w.first + 1;         // pair 用 .first / .second 取值
2. unordered_map:把「查找」变成 O(1)
它是什么:哈希表。本题用它存「某个前缀和出现在哪个下标」。因为元素全为正,每个前缀和的值只会出现一次,所以一个值对应一个下标,正好合适。
为什么有用:滑动窗口之外的另一条找段思路就是它——已知 P[i],想知道「有没有某个 P[start] = P[i] − target」,查表 O(1)。
unordered_map<long long, int> pos;
pos[0] = 0;                               // 空前缀的和为 0,对应下标 0
long long pre = 0;
for (int i = 1; i <= n; ++i) {
    pre += arr[i-1];
    auto it = pos.find(pre - target);     // 找「能凑出这段的左端点」
    if (it != pos.end()) { /* 找到一段 */ }
    pos[pre] = i;
}
3. 前缀和:把「区间和」变成「两个数相减」
它是什么:P[i] 表示前 i 个元素之和。于是任意区间 [l, r] 的和 = P[r+1] − P[l]。
为什么有用:它把「区间和等于 target」这个关于一段的判断,变成了「两个前缀之差等于 target」这个关于两个点的判断——两个点的关系可以用哈希表或双指针解决。
vector<long long> P(n + 1, 0);
for (int i = 0; i < n; ++i) P[i+1] = P[i] + arr[i];
// 区间 [l, r] 的和: P[r+1] - P[l]
4. 双指针滑动窗口:单调性换来的 O(n)
它是什么:维护一个 [lo, hi] 窗口,hi 只增、lo 只增。本题靠「元素全为正」保证窗口和随 hi 增而增、随 lo 增而减。
为什么有用:如果 lo 会来回移动,复杂度就退化回 O(n²);正因为两个指针都单向,总移动次数才是 2n。
long long sum = 0; int lo = 0;
for (int hi = 0; hi < n; ++hi) {
    sum += arr[hi];
    while (sum > target && lo <= hi) sum -= arr[lo++];   // lo 只前进
    if (sum == target) { /* 记录这段 */ }
}
5. long long:为什么区间和不能用 int 累加
它是什么:64 位整数。本题 n ≤ 10⁵、arr[i] ≤ 1000,总和最大 10⁸,仍在 int(约 2.1×10⁹)范围内——所以本题用 int 其实不会溢出。
为什么还是用 long long:这是习惯问题。target 的约束是 ≤ 10⁸,如果哪天数据范围上调(比如 arr[i] 到 10⁴),int 立刻溢出,而这类溢出在本地小数据上测不出来。用 long long 累加的成本可以忽略,收益是免掉一类难查的错。
6. INF 哨兵:怎么表达「还不存在」
它是什么:const int INF = 1e9;,用它表示「这个位置还没有任何合格段」。
为什么有用:取最小值时,不存在的值必须比任何真实值都大,否则会污染答案。本题 INF + INF = 2×10⁹ 仍在 int 内(上限约 2.147×10⁹),不会溢出——但只差一点点,所以更稳的写法是先判断 == INF 再相加。
const int INF = 1e9;
if (bestEnd[k - 1] == INF || bestStart[k] == INF) continue;   // 先挡掉「不存在」
answer = min(answer, bestEnd[k - 1] + bestStart[k]);
return answer >= INF ? -1 : answer;                           // 最后把 INF 翻译成 -1
7. 前缀最优 / 后缀最优:一个正扫、一个反扫
它是什么:把「每个位置自己的值」变成「到这个位置为止的最优值」。正向扫得到 bestEnd(右端点不超过 r 的最短长度),反向扫得到 bestStart(左端点不小于 l 的最短长度)。
为什么有用:它把「在某个范围内取最优」这件事预计算好,之后每个切点只需 O(1) 查询。这是用空间换时间最典型的形态,也是本题第三、四节的共同骨架。
for (int r = 1; r < n; ++r)      bestEnd[r] = min(bestEnd[r], bestEnd[r - 1]);     // 正向
for (int l = n - 2; l >= 0; --l) bestStart[l] = min(bestStart[l], bestStart[l + 1]); // 反向
8. std::span:不改所有权地「看见」一段内存(C++20)
它是什么:一个「指针 + 长度」的视图,不持有数据、不拷贝。span<const int> 表示「只读地看到一串 int」。
为什么有用:函数想接收「一段数组」时,老写法要么传 vector(绑死容器类型)、要么传「指针 + 长度」(两个参数容易配错)。span 一个参数就把两件事说清,而且能接 vector、原生数组、array 等各种来源。
void inspect(span<const int> s) {          // 不改内容、不拷贝
    int mx = *ranges::max_element(s);
    (void)mx;
}
vector<int> v{3, 2, 2, 4, 3};
inspect(v);                                 // vector 直接传
int raw[5] = {1, 2, 3, 4, 5};
inspect(raw); // 原生数组也能传本题用在哪:如果要把「找最优段」抽成一个辅助函数,参数用 span<const int> 比 const vector<int>& 更通用——它同时接受 vector 与原生数组,而且明确表达「我只读、不持有」。力扣 C++23 环境实测可用(提交 749680173)。
9. std::views::iota + ranges::min:把「枚举下标」写成管道(C++20/23)
它是什么:views::iota(a, b) 生成 a, a+1, …, b-1 的惰性序列;views::transform(f) 把每个元素映射成 f(x);ranges::min 取最小值。三者用 | 串起来就是一条管道。
为什么有用:本题「枚举切点 k,取 bestEnd[k-1] + bestStart[k] 的最小值」本质上是「对一串候选取最小」。老写法要写一个带 INF 哨兵的循环,管道写法直接表达意图,且不需要初始化哨兵。
// 老写法:手写循环 + INF 哨兵
int answer = INF;
for (int k = 1; k < n; ++k) {
    if (bestEnd[k-1] == INF || bestStart[k] == INF) continue;
    answer = min(answer, bestEnd[k-1] + bestStart[k]);
}
return answer >= INF ? -1 : answer;

// 管道写法:把「候选集合」直接表达出来
auto cand = views::iota(1, n)
          | views::filter([&](int k){ return bestEnd[k-1] != INF && bestStart[k] != INF; })
          | views::transform([&](int k){ return bestEnd[k-1] + bestStart[k]; });
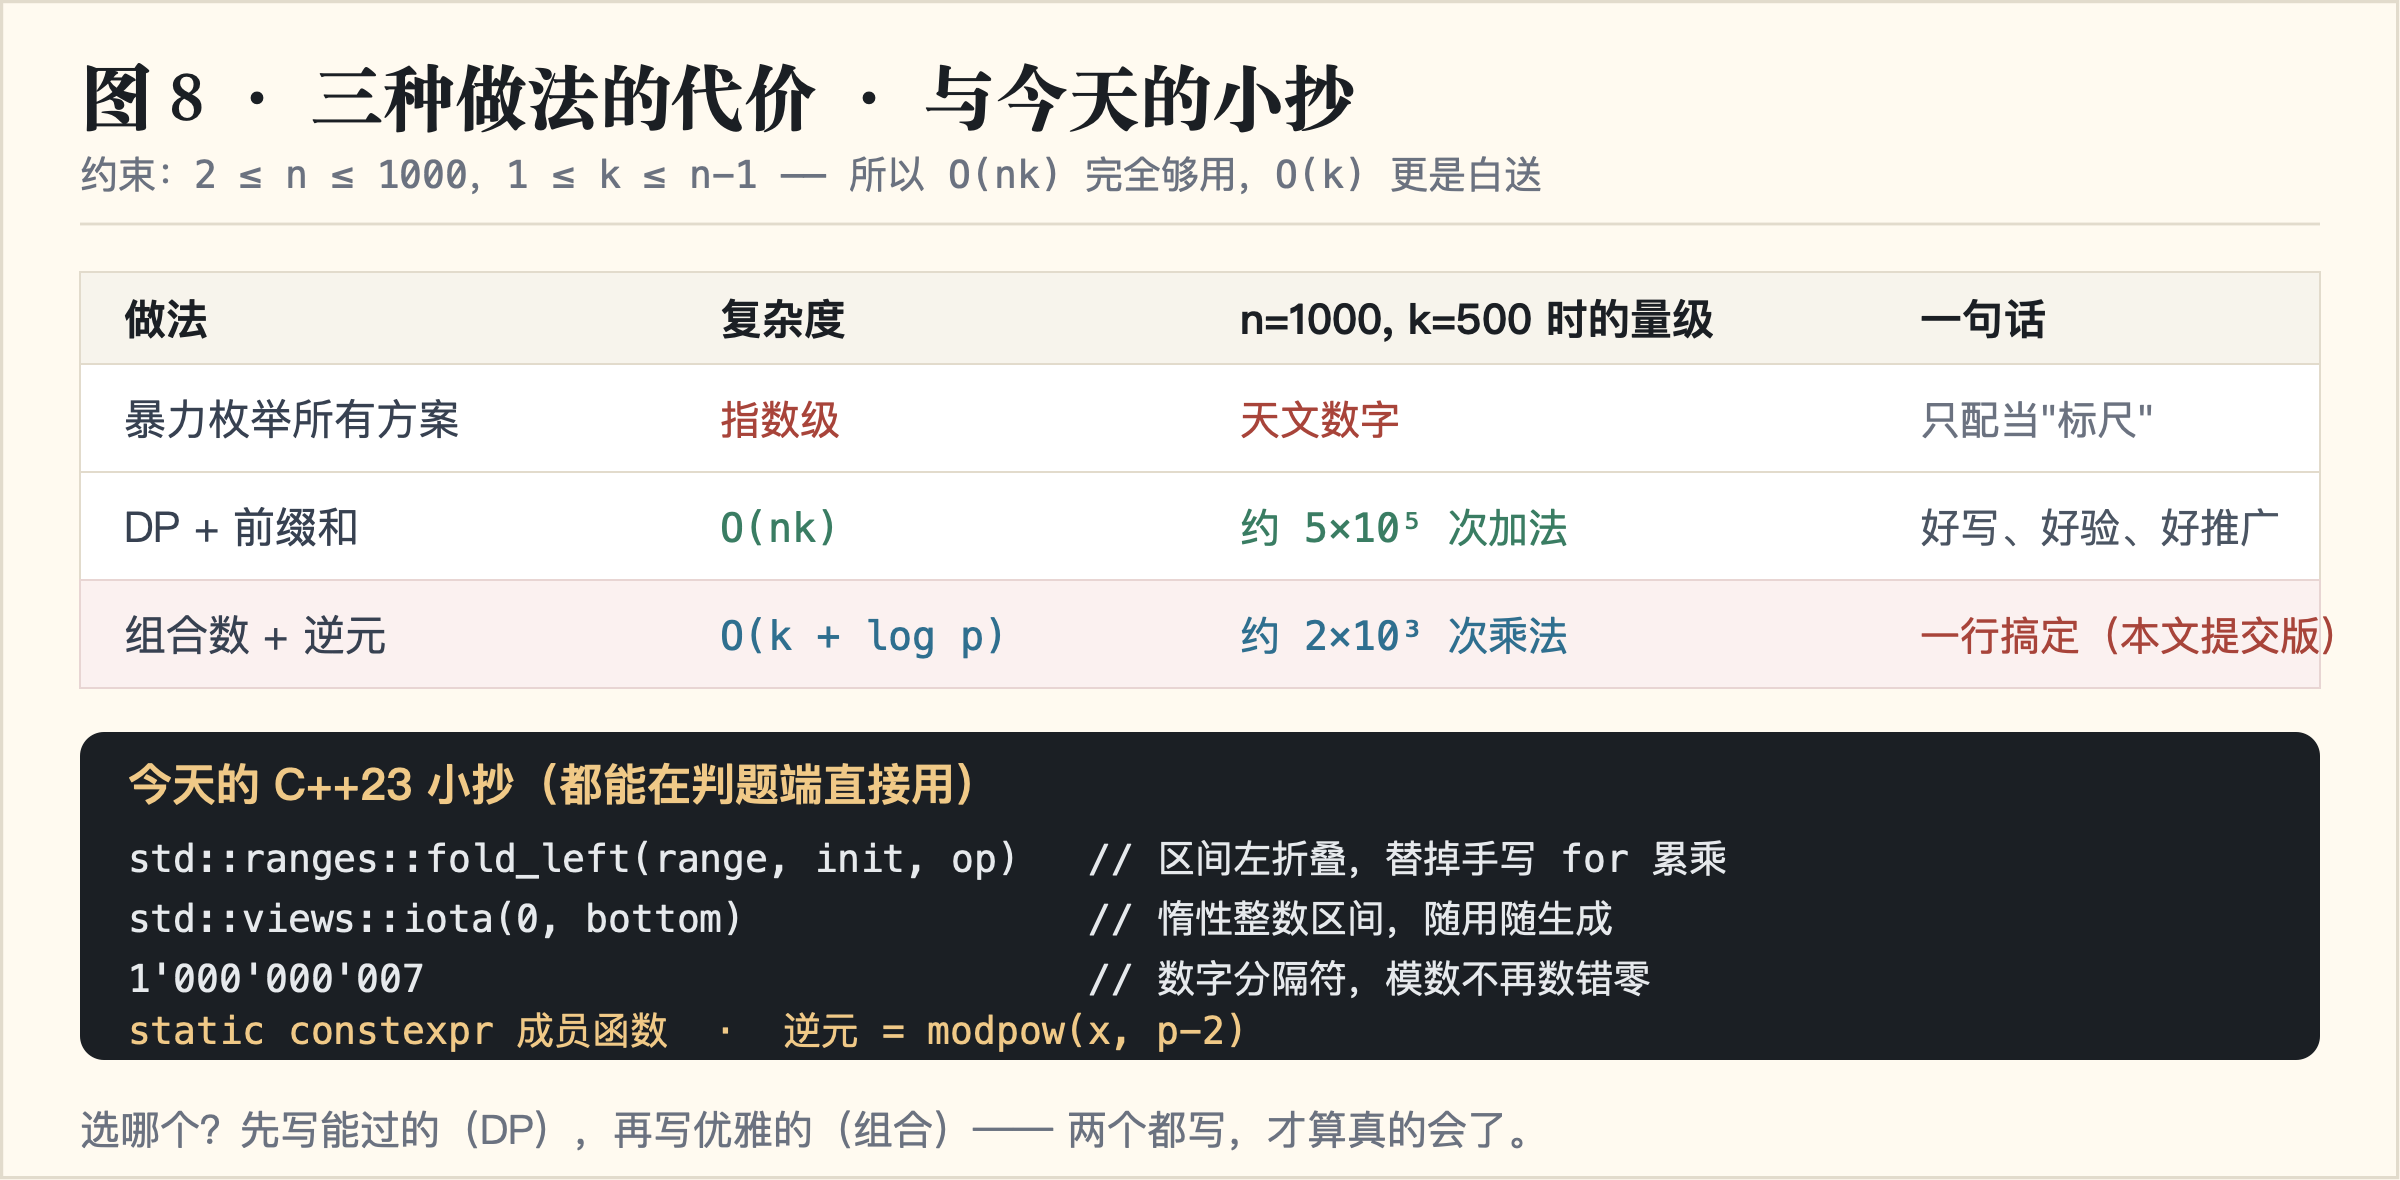
return ranges::empty(cand) ? -1 : ranges::min(cand);本题用在哪:两种写法都对、复杂度也相同(都是 O(n))。但它读起来更像「在说什么」而不是「在怎么做」,所以我把它作为可选写法写在附录里,主解仍是循环版(第 六 节那份就是实际提交、通过 61/61 的版本)。力扣 C++23 环境实测可用:views::iota / views::transform / ranges::fold_left 均编译并通过求值(提交 749680038、749680173)。
10. std::ranges::fold_left:把整段「折」成一个值(C++23)
它是什么:C++23 新算法,签名是 fold_left(区间, 初值, 二元操作),从左到右把整段折成一个值。它和 std::accumulate 的差别是:直接接受 range(不用写 begin/end),且能被管道喂进来。
为什么有用:凡是「遍历一遍、累加/累积/合并成一个值」的循环,都可以写成一行。它把「怎么遍历」从代码里拿掉,只留「怎么合并」——这正是本题「区间和」那类循环的常见形态。
vector<int> v{3, 2, 2, 4, 3};
long long total = ranges::fold_left(v, 0LL, plus<long long>());   // 14
// 配合管道:先映射再折
auto sum = ranges::fold_left(
    views::iota(1, 10) | views::transform([](int x){ return x * 2; }),
0LL, plus<long long>()); // 90本题用在哪:本题的「窗口和」是滑动的(右端加、左端减),fold_left 只做单向折叠,因此不适合替换主解的窗口维护——这正是第 4 条纪律「不许为了新而新」的例子:这里用它反而别扭。但它在「求整个数组的前缀和」「统计满足条件的个数」这类场景里很顺手,所以仍然收进小抄。
11. std::format / std::bit:格式化与位运算的小工具(C++20/23)
它是什么:std::format 是 printf 的类型安全替代(不写 %d、不会因为格式串和实参不匹配而崩);std::bit_width(x) 返回表示 x 所需的位数,std::has_single_bit(x) 判断是不是 2 的幂。
为什么有用:调试时打日志、写对数器时输出用例,format 比 cout << 拼接或 printf 都清楚;位运算类题(本题标签里没有位运算,但位运算题很常见)用 bit_width 比手写 while (x) { x >>= 1; ++cnt; } 可靠。
string msg = format("k={} left={} right={}", k, bestEnd[k-1], bestStart[k]);   // 类型安全
int bitsNeeded = bit_width(255u);            // 8
bool isPow2 = has_single_bit(1024u); // true本题用在哪:写对数器时用 format 输出反例(比手拼字符串清楚,也不会像 printf 那样格式串写错就崩);bit 里的工具本题没用到,但同栏目遇到位运算题会用到,一并收进小抄。力扣实测可用(提交 749680038 用到 format 与 has_single_bit)。
12. C++23 能力边界:什么能用、什么别用(实测)
它是什么:力扣 C++ 编译器的标准版本与特性支持范围——这一条不是语法,是「环境事实」。
为什么有用:用了环境不支持的写法,代价是一次编译错误和一个提交冷却;提前知道边界可以省掉这些。
| 能力 | 实测 | 证据(提交 id) |
|---|---|---|
__cplusplus | 202302 → C++23 | 749680035 |
ranges / fold_left / format / span / expected / numbers / bit | ✅ 编译并求值通过 | 749680038 / 749680173 |
deducing this(this auto&&) | ✅ 可用 | 749680173 |
std::stacktrace | ❌ 头在但链接失败 | 749680170 |
std::mdspan | ❌ 头不存在 | 749680166 |
本题用在哪:上面第 8–11 条能放心写,正是因为这一条先测过。**这张表随时会过期**——力扣升级编译器后要重新探。本文的探测方法很简单:把特性写进 Solution 提交,看它是「Compile Error」还是能跑到 WA/AC。